GPT-5.3-Codex-Spark: что это за модель, где использовать и какие есть аналоги
GPT-5.3-Codex-Spark — отдельная сверхбыстрая модель OpenAI для коротких интерактивных задач программирования в Codex. Она полезна, когда разработчику нужен первый рабочий diff за секунды и он готов вести модель небольшими итерациями.

GPT-5.3-Codex-Spark — отдельная сверхбыстрая модель OpenAI для коротких интерактивных задач программирования в Codex. Она полезна, когда разработчику нужен первый рабочий diff за секунды и он готов вести модель небольшими итерациями. Для долгого автономного рефакторинга, анализа всего монорепозитория или архитектурных решений лучше выбрать GPT-5.6 Sol, GPT-6 Astra либо другой более сильный агентный вариант. На 6 сентября 2026 года Spark остается research preview только для подписчиков ChatGPT Pro; общедоступного API и отдельной цены за токены у него нет.
Что такое GPT-5.3-Codex-Spark
Официальное название модели — GPT-5.3-Codex-Spark, а идентификатор в селекторе Codex — gpt-5.3-codex-spark. Сокращения «Codex 5.3 Spark» и «Codex Spark» удобны в разговоре, но могут создавать путаницу: Spark не равен GPT-5.3-Codex и не является настройкой скорости для этой модели.
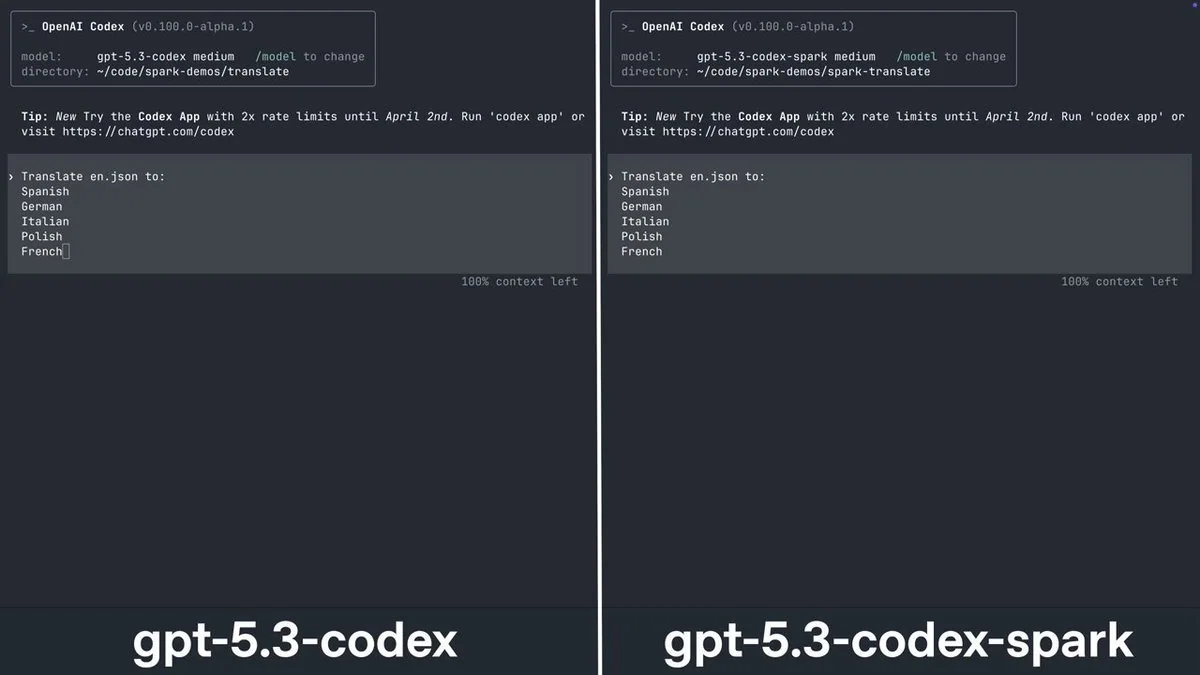
OpenAI выпустила Spark 12 февраля 2026 года как уменьшенную версию GPT-5.3-Codex и первую свою модель, специально рассчитанную на программирование в реальном времени. Она работает на низколатентном оборудовании Cerebras Wafer Scale Engine 3. В официальном релизе указана скорость более 1000 выходных токенов в секунду. Это позиционирование сервиса, а не обещание, что каждый запрос на любом соединении будет идти с постоянной скоростью 1000 токенов/с.
Главная идея Spark — сократить цикл «попросил → увидел изменение → уточнил». Модель рассчитана на точечные правки, перестройку небольшой части логики и быструю доводку интерфейса. Ей можно отправить уточнение во время работы и сразу перейти к следующей итерации.
| Характеристика | GPT-5.3-Codex-Spark на 06.09.2026 |
|---|---|
| Статус | research preview |
| Основная роль | интерактивный кодинг с минимальной задержкой |
| Контекст | 128K токенов |
| Вход | только текст |
| Reasoning effort в текущем селекторе Codex | low, medium, high, xhigh |
| Поведение по умолчанию | небольшие точечные изменения; тесты автоматически не гарантированы |
| Доступ | ChatGPT Pro, отдельный лимит |
| Общедоступный API | нет |
| Публичная цена Spark за токены/кредиты | не опубликована |
OpenAI сообщает, что Spark показал сильные результаты на SWE-Bench Pro и Terminal-Bench 2.0 и выполнял задания за долю времени GPT-5.3-Codex. Полной воспроизводимой таблицы с условиями каждого запуска в текстовом релизе нет. Поэтому этот тезис полезен как описание роли модели, но не заменяет тест на вашем репозитории.
Где доступна модель и сколько она стоит
Во время research preview Spark доступен только подписчикам ChatGPT Pro в актуальных версиях Codex app, Codex CLI и расширения для IDE. На текущей странице тарифов Codex Spark отмечен только для Pro: его нет в перечне возможностей Plus, Business, Enterprise/Edu и входа с API key.
Тариф Pro начинается от $100 в месяц, но это цена подписки с набором возможностей, а не прайс Spark. Для самой модели OpenAI не указывает ставку за миллион входных или выходных токенов. В тарифной таблице вместо чисел стоит пометка research preview.
У Spark собственный лимит, который не списывается из обычного лимита моделей Codex. Его размер OpenAI публично не фиксирует и может менять в зависимости от спроса. В часы нагрузки возможны очередь или временно ограниченный доступ. Остаток общего использования Codex можно смотреть в панели usage или через /status, но не следует превращать наблюдение одного аккаунта в универсальный лимит для всех Pro-пользователей.
Подписка Codex и API — разные способы доступа
При входе через ChatGPT Codex использует права плана и лимиты workspace. При входе с API key пользователь платит по тарифам OpenAI API и получает только те модели, которые разрешены ключу. API-вход подходит для CI и программных запусков, но не открывает Spark.
В феврале OpenAI сообщала о доступе к Spark API для небольшой группы design partners. Это закрытый партнерский preview. По состоянию на 6 сентября Spark отсутствует в публичном каталоге API-моделей и недоступен в feature-таблице для API key. Следовательно, gpt-5.3-codex-spark — рабочий slug выбора внутри подписочного Codex, но не общедоступный API SKU.
Нельзя брать тариф GPT-5.3-Codex и подписывать им Spark. У GPT-5.3-Codex есть собственная API-карточка и цена $1,75 за миллион входных и $14 за миллион выходных токенов. Это другая модель.
Для каких задач Spark подходит лучше всего
Spark раскрывается там, где задачу можно проверить быстро, а работа идет серией маленьких решений.
Точечные изменения интерфейса
Хороший сценарий — поправить состояние кнопки, отступы, типографику, обработку пустого списка или один компонент по готовой текстовой спецификации. Разработчик сразу видит diff, запускает preview и уточняет следующий шаг.
Поскольку Spark принимает только текст, скриншот нельзя передать ему как изображение. Сначала опишите видимый дефект и ожидаемое состояние либо получите текстовую спецификацию с помощью мультимодальной модели.
Исправление локального бага с готовым тестом
Если ошибка уже воспроизводится одной командой, Spark может быстро пройти короткий цикл: прочитать тест и целевую функцию, предложить минимальный патч, снова запустить тест. Чем точнее критерий готовности, тем меньше цена ошибки быстрой модели.
Небольшой рефакторинг с жесткими границами
Модель подходит для переименования локального API, выделения маленькой функции, устранения дублирования в нескольких файлах или обновления одного адаптера. В запросе нужно перечислить неизменяемые контракты и команды проверки.
Быстрая разведка по коду
Spark можно поручить найти обработчик маршрута, проследить один вызов, объяснить небольшой модуль или составить список релевантных файлов. Такой поиск полезен перед передачей сложной реализации более сильной модели.
Где Spark слабее и когда переключаться
Скорость не компенсирует недостаток контекста или глубины, если задача изначально длинная и неоднозначная.
| Сигнал | Почему Spark не лучший выбор | Куда переключиться |
|---|---|---|
| Нужно изменить десятки модулей и сохранить много неявных контрактов | 128K быстро заполняются кодом, логами и результатами инструментов | GPT-5.6 Terra или Sol |
| Нужна автономная работа в течение часов | Spark создан для управляемого realtime-цикла | GPT-5.6 Sol |
| Ошибка требует сложного межсистемного reasoning | цена неверной гипотезы выше выигрыша в задержке | GPT-5.6 Sol или GPT-6 Astra |
| Миграция затрагивает архитектуру, данные, безопасность и rollout | требуется максимальная связность решений и проверок | GPT-6 Astra |
| Нужно понять скриншоты, макеты или схемы | Spark принимает только текст | Luna, Terra, Sol, Astra, Gemini 3.7 Flash или Claude |
| Нужен массовый CI через API | публичного API Spark нет | GPT-5.6 Luna/Terra или API-аналог другого провайдера |
| Несколько повторов не проходят один и тот же тест | дальнейшие быстрые попытки создают лишний churn | зафиксировать состояние и эскалировать |
Практический порог прост: если после двух коротких итераций модель не воспроизвела дефект, расширяет scope без причины или повторяет одну гипотезу, сохраните diff и передайте задачу Terra, Sol или Astra. Не стоит заполнять 128K десятками неудачных попыток.
Как давать Spark задачи
У быстрой модели особенно заметна разница между коротким контрактом и расплывчатым пожеланием. Полезный запрос содержит пять частей:
- Один измеримый результат.
- Целевые файлы или разрешение сначала найти их через
rg. - Границы: какие API, данные и файлы нельзя менять.
- Обязательные команды тестирования.
- Формат отчета: diff, результаты проверок и остаточные риски.
Например:
В src/cart/discount.ts исправь округление скидки для JPY.
Публичный API и остальные валюты не меняй.
Сначала добавь тест, воспроизводящий ошибку, затем внеси минимальный diff.
Запусти bun test src/cart/discount.test.ts и bun run typecheck.
В конце перечисли измененные файлы, результаты команд и оставшиеся риски.
Такой контракт учитывает важную особенность Spark: OpenAI прямо указывает, что модель по умолчанию предпочитает минимальные правки и не запускает тесты без явной просьбы.
Как управлять контекстом 128K
Размер репозитория сам по себе не определяет успех. Важно, сколько текста реально попало в текущий контекст. Вместо команды «прочитай весь проект» лучше дать карту:
AGENTS.mdи локальные правила;- 2–8 вероятно релевантных файлов;
- одну ошибку или failing test;
- краткую схему входа и ожидаемого выхода;
- одну команду проверки.
Для длинной сессии делайте checkpoint: что доказано, какие файлы изменены, какие проверки прошли и что осталось. Затем продолжайте с этим резюме в чистом контексте. Старые сообщения, огромные логи и результаты всех инструментов полезны только до тех пор, пока влияют на следующее решение.
Как выбирать reasoning effort
В текущем селекторе Codex для Spark доступны low, medium, high и xhigh. OpenAI не публикует отдельную цену, гарантированную задержку или точность по каждому уровню. Поэтому начинать разумно с medium, а повышать effort — когда границы задачи уже ясны, но решение требует более глубокой проверки.
Не надо компенсировать плохой контекст уровнем xhigh. Если модель не видит контракт, тест или нужный файл, дополнительное reasoning не добавит отсутствующие данные. Сначала сузьте задачу и улучшите вход.
Spark и Fast mode: в чем разница
Spark — отдельная менее способная модель с собственным лимитом. Fast mode ускоряет поддерживаемую базовую модель и расходует кредиты быстрее. В документации Speed для GPT-5.6, GPT-5.5 и GPT-5.4 указан прирост скорости в 1,5 раза; Spark позиционируется отдельно и на специализированном тракте превышает 1000 токенов/с.
Выбор зависит от задачи:
- Spark — для максимально плотного интерактивного цикла и небольших правок;
- Fast mode сильной модели — когда качество этой модели нужно сохранить, но задержку хочется снизить;
- обычный режим Sol или Astra — когда время ответа менее важно, чем глубина, автономность и надежность.
Какие у GPT-5.3-Codex-Spark есть аналоги
Прямого клона Spark нет: сочетание отдельной модели, Codex-интерфейсов, Cerebras и подписочного лимита уникально. Сравнивать нужно не названия, а роль в рабочем процессе. Цены в таблице проверены 6 сентября 2026 года и относятся к миллиону токенов API. Они не равны стоимости отдельного лимита Spark в Pro.
| Решение | Ближайшая роль | Контекст | Цена input/output | Когда выбрать вместо Spark |
|---|---|---|---|---|
| GPT-5.6 Luna | дешевый исполнитель массовых хорошо заданных задач | 1,05 млн | $0,20 / $1,20 | нужен API, CI, изображения или большой объем |
| GPT-5.6 Terra | баланс качества и стоимости | 1,05 млн | $2 / $12 | правка шире локальной, но Sol избыточен |
| GPT-5.6 Sol | сложная агентная работа | 1,05 млн | $4 / $20 | долгий refactor, диагностика, много инструментов |
| GPT-6 Astra | самые сложные end-to-end задачи | 1,05 млн | $10 / $50 | критичная архитектура, безопасность, неоднозначность |
| Claude Haiku 4.5 | самый быстрый Claude | 200K | $1 / $5 | нужен быстрый общедоступный API, а не Codex preview |
| Claude Sonnet 5 | быстрый баланс интеллекта и качества | 1 млн | $2 / $10 | нужен более сильный универсальный coding-agent через API |
| Gemini 3.7 Flash | быстрый повседневный кодинг и tool use | 1 048 576 | $0,75 / $3,75 до 31.12.2026 | нужны API, мультимодальность, batch/flex/priority |
| Qwen3-Coder-Next | локальный open-weight coding agent | 256K | тариф модели отсутствует | нужен локальный контроль и есть свое железо/serving |
Альтернативы внутри OpenAI
Luna дешевле всего для массовых API-вызовов, но ее роль — cost-sensitive high volume, а не сверхнизкая задержка в Codex. Terra подходит, когда задача требует больше рассуждения и контекста без цены флагмана. Sol рассчитан на сложную профессиональную работу. Astra — самый сильный вариант для тяжелых end-to-end процессов.
Цены Sol в $4/$20 заявлены как промо минимум до 21 ноября 2026 года. Для запросов OpenAI длиннее 272K действуют повышающие коэффициенты, поэтому большой контекст нельзя считать бесплатным преимуществом.
Anthropic
Claude Haiku 4.5 ближе к Spark по роли «самый быстрый небольшой исполнитель», но это универсальная API-модель с контекстом 200K, а не отдельный realtime-тракт редактора. Claude Sonnet 5 ближе по балансу качества и скорости: Anthropic называет его лучшим сочетанием этих свойств, дает контекст 1M и цену $2/$10.
У Anthropic есть Fast mode, но он относится к Opus 5 и Opus 4.8, работает как премиальный режим API и не делает Sonnet или Haiku точной копией Spark.
Gemini 3.7 Flash — практичный аналог для быстрых повседневных coding loops. Google описывает модель как высокоскоростную для кодинга, agentic tool use и многошагового выполнения. Она принимает текст, изображения, видео, аудио и PDF, поддерживает function calling, code execution, computer use в preview и контекст больше миллиона токенов.
До конца 2026 года Standard API стоит $0,75 за миллион входных и $3,75 за миллион выходных токенов, включая thinking. Priority стоит дороже. Это делает Gemini удобнее для программной интеграции, но само наличие Flash в названии не доказывает задержку уровня Spark.
Open-weight вариант
Qwen3-Coder-Next создан именно для coding agents и локальной разработки. У модели 80 млрд параметров, из которых активируются 3 млрд, контекст 256K и лицензия Apache 2.0. Ее можно развернуть через vLLM или SGLang и подключить к CLI/IDE-агенту.
У open-weight модели нет единой цены за токены: стоимость зависит от GPU, квантизации, длины контекста, параллелизма и загрузки. Локальный запуск дает больше контроля над данными, но переносит на команду обслуживание, безопасность, наблюдаемость и проверку качества.
Как честно сравнить Spark с аналогами
Чужой рейтинг редко отвечает на вопрос, какая модель выгоднее именно в вашем проекте. Нужен один commit, одинаковые задачи и автоматическая приемка результата.
| ID | Задача | Проверка |
|---|---|---|
| T1 | локальная правка React/CSS по текстовому brief | screenshot diff и e2e |
| T2 | баг с готовым failing test | до патча тест красный, после — зеленый |
| T3 | refactor 6–12 файлов без изменения API | unit tests и typecheck |
| T4 | поиск причины сбоя по логам | скрытый regression test |
| T5 | неоднозначная архитектурная миграция | rubric, тесты и слепой review |
Для каждого запуска создайте чистый worktree на одном SHA, выдайте одинаковый AGENTS.md, task brief, инструменты, таймаут и команды проверки. Выполните не менее пяти повторов для каждой пары «модель × задача» и перемешайте порядок моделей.
Записывайте не только полный wall-clock:
- время до первого полезного diff;
- долю полностью прошедших тестов;
- количество регрессий;
- число вмешательств человека;
- токены, кредиты или стоимость;
- объем diff;
- версию клиента и дату запуска.
Минимальная JSONL-запись может выглядеть так:
{"run_id":"T2-spark-01","model":"gpt-5.3-codex-spark","effort":"medium","client":"codex X.Y","commit":"<sha>","ttfd_s":null,"wall_s":null,"tests_passed":null,"regressions":null,"human_interventions":null,"tokens_or_credits":null,"cost_usd":null,"notes":""}
До реального прогона поля остаются null. Ноль означает измеренное нулевое значение, а не отсутствие данных. Для Spark фиксируйте расход подписочного лимита, если интерфейс его показывает; не пересчитывайте его в доллары по тарифу GPT-5.3-Codex.
Данные и закрытый код
У Spark нет отдельной опубликованной политики хранения данных. Правила определяет способ входа и ваш workspace. При входе через ChatGPT применяются права и настройки хранения ChatGPT workspace; при API key — настройки API organization. Это различие описано в документации аутентификации Codex.
Публичный Spark сейчас работает через ChatGPT Pro, поэтому нельзя автоматически приписывать личному Pro-сеансу правила API. Перед загрузкой проприетарного репозитория проверьте Data Controls и договорные условия своего workspace. Не храните в коде и не отправляйте модели production-ключи, токены, дампы персональных данных и секреты окружения.
Вывод
GPT-5.3-Codex-Spark стоит выбирать ради скорости взаимодействия, а не как универсально лучшую модель для программирования. Ее оптимальный контур — маленькая проверяемая задача, узкий набор файлов, минимальный diff и явно заданные тесты. Контекст 128K и text-only вход требуют дисциплины, зато разработчик может быстро перебирать варианты без долгого ожидания.
Если задача растет, переключайтесь рано: Luna — для дешевого API и объема, Terra — для баланса, Sol — для сложной агентной работы, Astra — для самых тяжелых end-to-end решений. Среди других providers близкие роли выполняют Claude Haiku/Sonnet, Gemini 3.7 Flash и локальный Qwen3-Coder-Next. Окончательный выбор должен решить собственный benchmark на одном репозитории, а не название модели или чужой скриншот с баллами. Практическое сравнение вариантов для разработки собрано в обзоре ИИ-сервисов для программирования.
Автор статьи

Контент-менеджер AI-раздела
Отвечает за каталог нейросетей и AI-инструментов. Следит за обновлениями LLM-моделей, тестирует новые сервисы и ведёт раздел бесплатных инструментов.
Вопросы и ответы
Нет. Spark — уменьшенная отдельная модель для кодинга в реальном времени. GPT-5.3-Codex рассчитан на более глубокую агентную работу и имеет отдельную публичную API-карточку.
Нет. Fast mode ускоряет поддерживаемую базовую модель за повышенный расход кредитов. Spark выбирается как самостоятельная модель и расходует отдельный лимит.
На 6 сентября 2026 года нет. Research preview указан только для ChatGPT Pro.
Обычный API-ключ не дает публичного доступа. OpenAI сообщала о закрытом API-preview для design partners, но текущий публичный каталог и тарифная таблица Spark для API key не показывают.
Модель входит в ChatGPT Pro и имеет отдельный изменяемый лимит. Отдельную цену за миллион токенов или фиксированный кредитный тариф OpenAI не публикует. Цена Pro начинается от $100 в месяц, но включает не только Spark.
Нет, текущая версия text-only. Переведите требования к интерфейсу в текст или используйте мультимодальную модель для анализа изображения.
Да. OpenAI предупреждает, что облегченный стиль модели по умолчанию не предполагает автоматический запуск тестов. Укажите точные команды и критерий готовности в запросе.
Для локальной задачи — да, если сначала найти релевантные файлы и не загружать весь репозиторий в контекст. Для длинной миграции через десятки модулей лучше Terra, Sol или Astra.
Сначала обновите Codex app и CLI и повторите задачу в чистом сеансе. Такая ошибка уже встречалась как клиентская несовместимость параметров и сама по себе не означает, что Spark недоступен. Не публикуйте обходы с ручным редактированием служебного кэша без резервной копии и проверки версии.
Точного аналога нет. Для дешевых массовых заданий через OpenAI API начните с GPT-5.6 Luna, для более сложных — с Terra. Из других providers проверьте Gemini 3.7 Flash, Claude Haiku 4.5 или Sonnet 5. Если нужен локальный open-weight стек, рассмотрите Qwen3-Coder-Next.
Смотрите также

Где дешевле DeepSeek V4 Flash и V4 Pro — API, подписки и альтернативы
26 сентября 2026 г.

OpenCode Go: лимиты DeepSeek V4 Flash и Pro
26 сентября 2026 г.

Что такое Cursor CLI: как использовать и сравнение с конкурентами
25 сентября 2026 г.

Роутинг MCP и плагинов в ChatGPT/Codex, Claude Code, Cursor и Antigravity
25 сентября 2026 г.
Комментарии(0)
Оставьте комментарий
Войдите, чтобы присоединиться к обсуждению