GPT-5.6 Sol: какая разница в цене между Light, Medium, High и Extra High
У Light, Medium, High и Extra High для GPT-5.6 Sol нет отдельных ставок за токен. Это уровни усилия рассуждения одной модели, а не четыре тарифа. В API им соответствуют low, medium, high и xhigh; если интерфейс называет нижний уровень Light, каноническое значение параметра всё равно…
У Light, Medium, High и Extra High для GPT-5.6 Sol нет отдельных ставок за токен. Это уровни усилия рассуждения одной модели, а не четыре тарифа. В API им соответствуют low, medium, high и xhigh; если интерфейс называет нижний уровень Light, каноническое значение параметра всё равно low. При одинаковом числе входных и выходных токенов все четыре варианта стоят одинаково. Разница в итоговом расходе появляется потому, что высокий effort обычно даёт модели больший бюджет на рассуждение, увеличивает задержку и может породить больше reasoning tokens, вызовов инструментов и повторных шагов.
Цены и продуктовые условия ниже проверены на 6 сентября 2026 года. У GPT-5.6 Sol сейчас действует промоставка: $4 за миллион входных токенов, $0.40 за миллион кэшированных входных и $20 за миллион выходных. OpenAI обещает сохранять её как минимум до 21 ноября 2026 года. Точные значения и дату действия лучше перепроверять на странице модели GPT-5.6 Sol перед расчётом бюджета.
Что означают Light, Medium, High и Extra High
Выбор модели и выбор effort — два разных решения. Модель остаётся gpt-5.6-sol, а настройка reasoning effort задаёт, сколько вычислительного бюджета она может направить на внутреннее рассуждение перед ответом и между действиями. Через устройство рассуждающих моделей нейросетей проще понять, что именно меняет reasoning effort.
В англоязычном селекторе Codex нижний уровень называется Low. Название Light может встречаться как более понятная подпись в интерфейсе или локализации. Для API безопасно ориентироваться на машинные значения:
- Light/Low —
low; - Medium —
medium; - High —
high; - Extra High —
xhigh.
GPT-5.6 Sol также поддерживает none и max. В интерфейсе Codex может быть Ultra, но это уже режим с автоматическим делегированием задач субагентам, а не другое написание Extra High. Поэтому переносить выводы о расходе Ultra на xhigh нельзя.
| Уровень в интерфейсе | Значение API | Для каких задач начинать тест | Качество и задержка | Что может произойти с расходом |
|---|---|---|---|---|
| Light / Low | low |
классификация, извлечение, короткие правки, поиск простого факта, рутинный код с хорошими тестами | самый быстрый из четырёх, но меньше запаса на многошаговый анализ | обычно меньше reasoning tokens, однако не гарантирован фиксированный минимум |
| Medium | medium |
повседневная разработка, анализ документов, подготовка структурированного текста, задачи с несколькими зависимыми шагами | баланс; это default для GPT-5.6 Sol в API | хороший кандидат для базового замера бюджета и качества |
| High | high |
сложная отладка, архитектура, неоднозначные требования, агентная работа с инструментами | рассуждение глубже, ответ обычно приходится ждать дольше | возможны дополнительные reasoning tokens и действия; цену нужно измерять на задаче |
| Extra High | xhigh |
самые трудные проверяемые задачи, где High регулярно не проходит критерий качества | максимальная глубина среди этих четырёх, высокая задержка | самый высокий риск длинных рассуждений и большого расхода, но иногда меньше повторов компенсирует первый дорогой запуск |
Последняя оговорка важна. Light может быстро выдать неверный патч, после чего потребуются три попытки и ручная отладка. Extra High может решить ту же задачу одним проходом. У первой попытки Light чек ниже, но стоимость принятого результата способна оказаться выше.
Есть ли фиксированная наценка за более высокий effort
Нет. OpenAI не публикует таблицу вида «Medium = 1.5 Light» или «Extra High = 4 High» для GPT-5.6 Sol. Стандартная ставка API привязана к фактически учтённым токенам и платным инструментам, а не к названию reasoning effort.
Reasoning tokens входят в общее число выходных токенов. В ответе Responses API их можно увидеть в детализации output_tokens_details.reasoning_tokens, но прибавлять это значение к output_tokens повторно нельзя. Сервис уже включил их в общий output.
Отсюда следуют два разных утверждения:
- при фиксированных billing tokens уровень effort не меняет стоимость;
- в реальном запросе effort может изменить число этих токенов и весь путь выполнения, поэтому чек за задачу меняется.
Как посчитать стоимость GPT-5.6 Sol через API
Для стандартной обработки и контекста до порога long context расчёт выглядит так:
стоимость = вход без кэша × $4 / 1 000 000 + кэшированный вход × $0.40 / 1 000 000 + запись в кэш × $5 / 1 000 000 + весь output × $20 / 1 000 000 + платные вызовы инструментов
Ставка записи в кэш $5 получается как 1.25 от текущих $4 за некэшированный вход. Если запрос ничего не записывает в кэш и не вызывает платные инструменты, соответствующие слагаемые равны нулю.
Пример с одинаковыми входом и выходом
Запрос содержит 20 000 некэшированных входных токенов и возвращает 5 000 output tokens вместе с внутренним рассуждением:
- вход:
20 000 / 1 000 000 × $4 = $0.08; - выход:
5 000 / 1 000 000 × $20 = $0.10; - итого:
$0.18.
Если Light, Medium, High и Extra High показали ровно по 20 000 входных и 5 000 выходных токенов, каждый запрос стоит $0.18. По одной лишь подписи effort наценки нет.
Пример с кэшированным контекстом
В запросе 20 000 новых входных токенов, 80 000 кэшированных и 10 000 выходных:
- новый вход:
$0.08; - кэшированный вход:
80 000 / 1 000 000 × $0.40 = $0.032; - выход:
$0.20; - итого:
$0.312.
Этот расчёт не включает запись в кэш и инструменты: в условии их нет. Он показывает ещё одну частую ошибку — нельзя умножать весь вход на $4, если часть токенов действительно попала в оплачиваемый cached-input bucket.
Почему реальная сумма всё же различается
Представим один и тот же вход в 20 000 токенов. Ниже не прогноз GPT-5.6 Sol и не коэффициенты OpenAI, а арифметическая иллюстрация переменного output.
| Уровень | Условный output, включая reasoning | Вход | Выход | Итого |
|---|---|---|---|---|
| Light / Low | 4 000 | $0.08 | $0.08 | $0.16 |
| Medium | 8 000 | $0.08 | $0.16 | $0.24 |
| High | 16 000 | $0.08 | $0.32 | $0.40 |
| Extra High / XHigh | 32 000 | $0.08 | $0.64 | $0.72 |
Итог вырос только из-за условного числа output tokens. В другой задаче High может сделать меньше бесполезных вызовов, чем Medium, и оказаться дешевле на успешно завершённый результат.
Что ещё меняет счёт API
Длинный контекст
Если вход GPT-5.6 Sol превышает 272 000 токенов, для всего запроса включается long-context тарификация: вход становится вдвое дороже, выход — в 1.5 раза. Например, 300 000 входных и 20 000 выходных токенов без кэша стоят:
300 000 × $8 / 1 000 000 + 20 000 × $30 / 1 000 000 = $2.40 + $0.60 = $3.00.
Это скачок из-за размера контекста, а не из-за High или Extra High. Если в тесте один режим подтянул больше файлов и перешёл порог, сравнение без учёта long context получится ложным.
Инструменты и возвращаемый контекст
Web search, computer use и другие инструменты могут иметь отдельную цену за вызов. Результаты инструментов также попадают в контекст последующих шагов. Чем дольше агент ищет, читает и перепроверяет, тем больше становится не только число tool calls, но и токенный объём продолжения.
Повторные попытки
Retry после ошибки сети, новый запрос после плохого ответа и автоматический цикл исправления — отдельные расходы. Сравнивать нужно всю задачу до принятого результата. Один быстрый ответ за $0.10 и четыре исправления по $0.08 стоят $0.42, а успешный проход за $0.30 — $0.30.
Длина видимого ответа
reasoning.effort и text.verbosity решают разные задачи. Первый управляет глубиной рассуждения, второй — подробностью видимого текста. Короткий ответ не доказывает малого расхода: перед ним могло быть длинное внутреннее рассуждение. И наоборот, подробный текст может быть полезным результатом, а не потерями.
Режим обработки
Standard, Batch, Flex, Fast и другие service tiers могут иметь разные ставки или условия. Не следует принимать ценовую разницу между Fast и Standard за стоимость Extra High. В чистом тесте effort режим обработки нужно зафиксировать.
Чем отличаются API, Codex и ChatGPT по оплате
Одна и та же надпись GPT-5.6 Sol встречается в разных продуктах, но единица учёта зависит от способа входа.
| Сценарий | Что оплачивает пользователь | Как влияет effort | Где проверять факт |
|---|---|---|---|
| Прямой API | фактические токены, cache buckets, processing tier и платные tools | ставка Sol одна; расход меняется через фактическое использование | поле usage ответа и API dashboard |
| Codex с API key | тот же usage-based API billing | Light/Medium/High/Extra High не превращаются в подписочные тарифы | API dashboard |
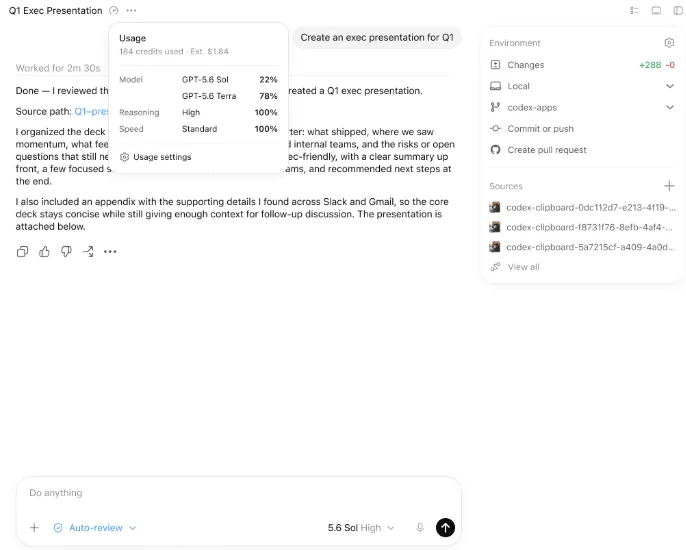
| Codex или ChatGPT Work в составе плана | доступ включён в план до динамического allowance; затем могут использоваться кредиты | higher reasoning может быстрее расходовать allowance, фиксированного множителя по уровням нет | usage dashboard, в Codex CLI — /status |
| Кредитная тарификация подходящего плана | credits по токенным ставкам продукта | больше фактических output/reasoning tokens — больше credits | условия workspace и usage dashboard |
Актуальные планы, ориентиры usage и credit rates собраны на странице цен ChatGPT Work и Codex. Там отдельно указано, что похожие задачи способны расходовать allowance по-разному: влияют модель, контекст, reasoning, инструменты, поиск и кэширование. Опубликованные оценки количества сообщений не являются обещанным лимитом для каждого аккаунта. Читать полный обзор сервиса ChatGPT
Практический пример для подписки: разработчик запускает в Codex короткую правку на Medium, а затем аудит всего репозитория на Extra High. У него не появляются две подписки и две цены за сообщение. Вторая задача, вероятно, заберёт больше общей ёмкости из-за контекста, рассуждения и инструментов. Точный расход виден после запуска, а не из названия уровня.
Практический пример для API key: два запроса вернули одинаковые billing buckets. Light и Extra High будут стоить одинаково. Если Extra High использовал больше output tokens, вызвал платный поиск или потребовал длинный контекст, счёт вырастет по соответствующим строкам тарификации.
Какой уровень выбрать
Не назначайте Extra High всему проекту по умолчанию. Начните с минимального уровня, который стабильно проходит проверку результата.
Для рутинной операции с автоматическими тестами разумно проверить Light/Low. Для обычной многошаговой работы — Medium. High нужен, когда в задаче есть неоднозначность, архитектурные компромиссы или сложная отладка. Extra High стоит включать для узкого класса самых трудных задач, если замеры показывают прирост принятого качества относительно High.
Дерево решения
- Результат легко проверить автоматически, а ошибка дёшево исправляется? Начните с Light/Low.
- Нужно удержать несколько зависимых шагов, файлов или требований? Начните с Medium.
- Medium регулярно не проходит тест, ревью или критерий полноты? Повторите тот же бенчмарк на High.
- High всё ещё не решает самые сложные примеры, а прирост качества важнее времени? Проверьте Extra High/XHigh.
- Более высокий effort не улучшил метрику? Вернитесь на нижний уровень. Дополнительное рассуждение без выигрыша — лишняя задержка и потенциальный расход.
- Все уровни Sol слишком дороги для массовой простой нагрузки? Сократите контекст, ограничьте инструменты и повторы либо отдельно протестируйте Terra/Luna. Смена модели — другой эксперимент, её нельзя смешивать с тестом effort.
Как провести собственный бенчмарк цены
Универсальной таблицы коэффициентов не существует, зато её можно получить для своего набора задач.
Сначала соберите репрезентативную выборку: реальные баги, документы, запросы клиентов или аналитические кейсы. Для каждого примера заранее задайте проверку — тесты, эталонные факты, рубрику качества или слепое ревью. Случаи, где любой длинный ответ кажется умнее, не подходят для ценового сравнения.
Затем зафиксируйте всё, кроме effort:
- точный model ID или snapshot;
- системные инструкции, промпт, файлы и порядок сообщений;
- набор инструментов и предел tool calls;
- service tier, кэш и максимальный output;
- критерий успеха и допустимую задержку.
Каждый уровень прогоните несколько раз и перемешайте порядок запусков. Единичная попытка слишком чувствительна к вариативности задачи, состоянию кэша и случайному удачному пути.
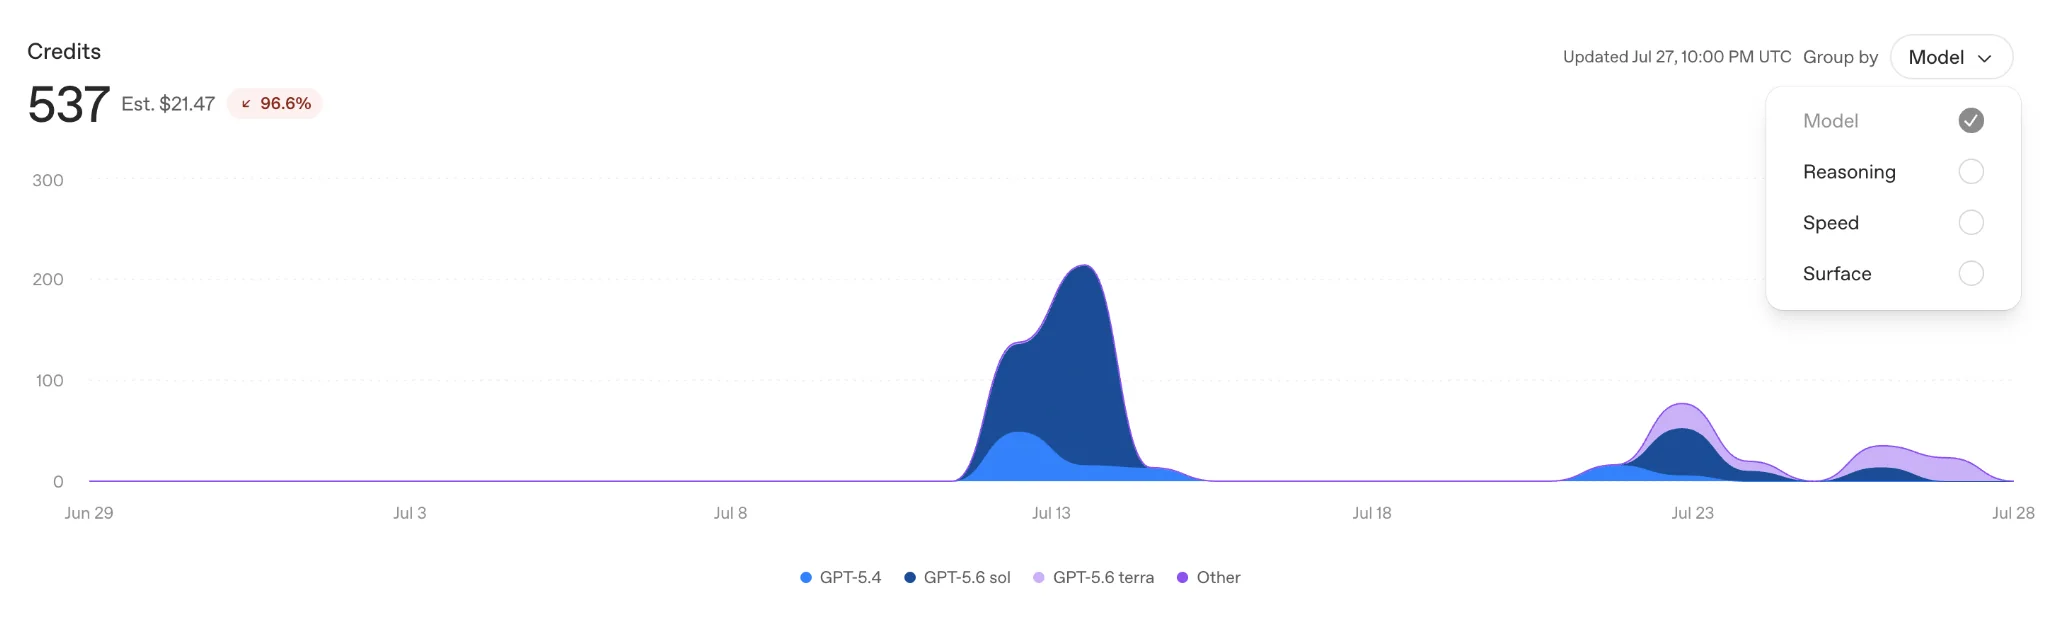
В журнал заносите input_tokens, cached_tokens, cache_write_tokens, output_tokens, reasoning_tokens, число tool calls и retries, время до результата и pass/fail. Главная метрика — не цена одного ответа, а стоимость успешно принятой задачи:
cost per passed task = общая стоимость всех попыток / число задач, прошедших проверку.
Рядом полезно смотреть медианную задержку, p95, долю успеха с первой попытки и минуты ручной доработки. Побеждает самый низкий effort, который выдерживает ваш порог качества и времени.
Ошибки при сравнении уровней
- Принимать Light, Medium, High и Extra High за разные модели или планы подписки.
- Искать официальный коэффициент цены там, где опубликованы только токенные ставки.
- Сравнивать видимую длину текста и не смотреть reasoning tokens.
- Прибавлять
reasoning_tokensк уже включающему ихoutput_tokens. - Сопоставлять API-доллары с процентами лимита ChatGPT/Codex как одинаковые единицы.
- Менять вместе effort, модель, промпт, service tier, инструменты и объём файлов.
- Считать первый запрос, но игнорировать retries, исправления и ручную работу.
- Не замечать переход через 272 000 входных токенов.
- Переносить чужой результат с Reddit на свой репозиторий или документы.
- Считать более высокий effort автоматически более качественным: модель может дольше исследовать слабую постановку и делать лишние действия.
Вывод
Разница в прайс-листе между Light, Medium, High и Extra High для GPT-5.6 Sol равна нулю: это значения reasoning effort одной модели. При фиксированных input, cached input и output tokens их API-стоимость одинакова. Реальная разница возникает в количестве токенов и действий, которые понадобились до принятого результата.
Для большинства новых рабочих сценариев разумная отправная точка — Medium. Light/Low подходит для дешёвых проверяемых операций, High — для сложных многошаговых задач, Extra High/XHigh — для редких случаев, где его прирост качества подтверждён бенчмарком. В подписке смотрите usage dashboard, а в API считайте billing buckets из поля usage. Только так цена уровня превращается из догадки в измеримую стоимость вашей задачи.
Автор статьи
Контент-менеджер AI-раздела
Отвечает за каталог нейросетей и AI-инструментов. Следит за обновлениями LLM-моделей, тестирует новые сервисы и ведёт раздел бесплатных инструментов.
Вопросы и ответы
Для настройки API используйте low. Публичная англоязычная документация Codex также пишет Low. Если конкретный интерфейс показывает Light, воспринимайте его как человекочитаемую подпись нижнего reasoning effort и проверьте фактическое значение в настройках или журнале запуска.
Нет. Это отображаемое название xhigh для той же gpt-5.6-sol. Отдельными моделями семейства являются Sol, Terra и Luna; их ставки различаются.
При одинаковых billing tokens — нет. В реальной задаче Extra High часто может использовать больше reasoning/output tokens и времени, но иногда он экономит на повторных попытках. Сравнивайте стоимость успешно принятого результата.
Длина промпта — только один фактор. Меняются удерживаемый контекст, reasoning, результаты инструментов, поиск, кэш и путь выполнения. Текущий allowance и время сброса проверяйте в dashboard или командой /status.
Нет. OpenAI не публикует фиксированную квоту reasoning tokens для Light, Medium, High и Extra High на каждый запрос. Фактическую детализацию смотрят после ответа в usage.outputtokensdetails.reasoningtokens.
Зависит от доли успешных результатов. Просуммируйте все попытки, вызовы инструментов и ручную доработку, затем разделите расходы на число принятых задач. Без такого теста ответ будет догадкой.
Не для любого кода. Начните с Medium, если задача многошаговая, и поднимите effort после воспроизводимого провала. Короткая правка с сильными тестами может хорошо работать на Light/Low, а сложная архитектура или отладка — выиграть от High либо XHigh.
Да. Reasoning tokens учитываются внутри output tokens. Не добавляйте их к output повторно при ручном расчёте.
Нет. Codex/ChatGPT Work в составе плана расходуют общий allowance и доступные кредиты по условиям плана. Запуски с API key тарифицируются отдельно по API usage.
Вернуться на High или Medium и проверить постановку задачи, критерий готовности, объём контекста и инструменты. Высокий effort полезен только при измеримом росте качества или снижении числа повторов.
Смотрите также
Аналоги OpenCode Go: чем заменить подписку за $10
22 сентября 2026 г.
Кто-то построил настоящий компьютер в Minecraft — как это возможно?
21 сентября 2026 г.
Аналоги GitHub в 2026 году: российские, мировые и self-hosted решения
18 сентября 2026 г.
Лучшие сервисы для проведения вебинаров в 2026 году: преимущественно российские
16 сентября 2026 г.
Комментарии(0)
Оставьте комментарий
Войдите, чтобы присоединиться к обсуждению